
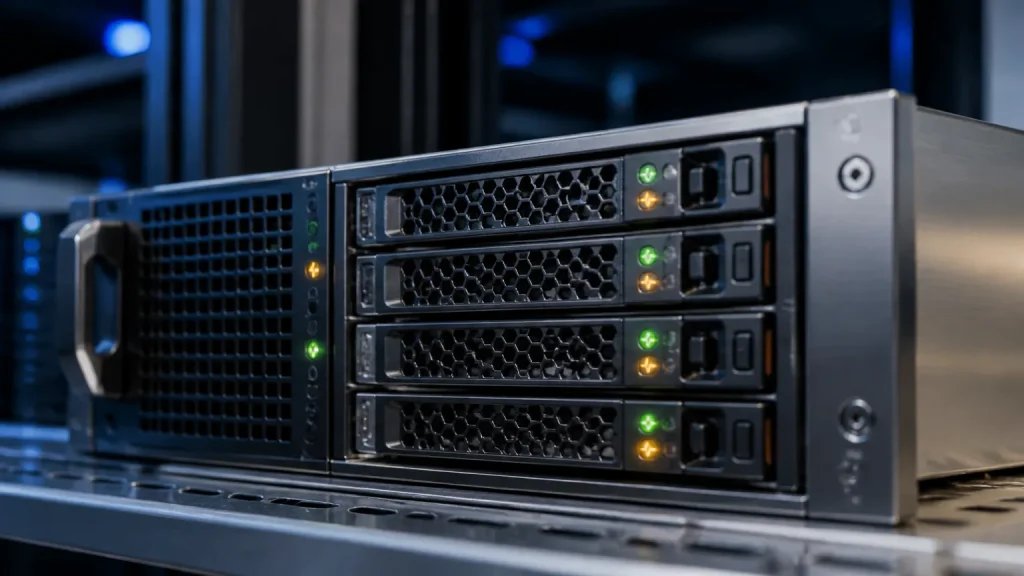
A busca por disponibilidade contínua leva muitas empresas a implementar o arranjo RAID 5 em seus servidores locais. Essa arquitetura equilibra desempenho operacional e investimento ao distribuir informações e paridade entre múltiplos discos rígidos, suportando a quebra mecânica de uma unidade sem paralisar a rotina produtiva da equipe.
Contudo, manter a tolerância a falhas de hardware ativa no servidor não significa que as informações do negócio estejam protegidas contra desastres reais. Falhas durante a reconstrução de discos, corrupção lógica de arquivos e infecções por ransomware exigem repositórios independentes para recuperação de desastre.
Nesse sentido, entender o cálculo de capacidade útil desse arranjo, os riscos operacionais envolvidos no rebuild e os motivos pelos quais a governança de infraestrutura moderna exige isolamento em repositórios externos torna-se indispensável.
Sumário
- Como funciona o RAID 5 e a paridade distribuída no armazenamento corporativo
- Cálculo de capacidade útil e os riscos do processo de rebuild no arranjo
- Comparativo entre tolerância a falhas e proteção de dados
- A regra 3-2-1 e a importância do isolamento físico com repositório externo
- Conclusão
- Perguntas Frequentes
Como funciona o RAID 5 e a paridade distribuída no armazenamento corporativo
Essa tecnologia de armazenamento é amplamente adotada em servidores corporativos para equilibrar custo, desempenho e resiliência mecânica. Diferente de configurações baseadas em espelhamento simples, o método distribui blocos de dados juntamente com informações de correção entre múltiplos discos físicos.
A base desse sistema fundamenta-se em três pilares operacionais essenciais:
- Paridade distribuída: as informações redundantes não ficam concentradas em uma unidade específica, mas fragmentadas de forma alternada entre todas as unidades do grupo.
- Tolerância a falhas de hardware: a arquitetura mantém a integridade operacional e o acesso contínuo aos dados mesmo após a quebra mecânica de uma unidade individual.
- Cálculo lógico por operação XOR: a reconstituição de informações faltantes é calculada instantaneamente pelos dados restantes combinados aos blocos de redundância pela controladora de armazenamento.
Para implementar essa estrutura, a infraestrutura exige no mínimo três unidades de disco ativas. A fórmula matemática que define o espaço disponível segue o princípio de capacidade líquida N menos 1, em que o volume total equivale à soma das unidades presentes subtraindo o espaço de uma delas reservado para a redundância lógica, como demonstrado em análises de armazenamento de dados para empresas.
Quando ocorre a perda de uma unidade física, o conjunto entra em estado degradado. O acesso aos dados permanece ativo, porém a taxa de transferência sofre impactos relevantes até que o disco avariado seja substituído e o processo de reconstrução seja finalizado. Compreender essa mecânica evita a suposição equivocada de que a continuidade de disco local substitui políticas formais de preservação externa de dados, sendo fundamental estabelecer um backup de dados estruturado.

Cálculo de capacidade útil e os riscos do processo de rebuild no arranjo
O dimensionamento de armazenamento estruturado nesse formato exige compreender a relação entre espaço bruto e espaço efetivamente disponível. A fórmula matemática aplicada pelo controlador segue a lógica em que uma parcela equivalente a exatamente uma unidade física fica reservada para a gravação dos blocos de paridade distribuída.
Em um conjunto composto por quatro discos de 4 TB, por exemplo, a capacidade total bruta é de 16 TB, mas o espaço utilizável para o sistema operacional da empresa será de 12 TB. Embora essa distribuição equilibre aproveitamento financeiro e disponibilidade operacional, o momento em que uma unidade falha expõe a infraestrutura a gargalos críticos de hardware.
A substituição do componente danificado inicia o processo de reconstrução de dados, etapa de intensa atividade mecânica e computacional. Durante essa rotina, o controlador precisa ler integralmente todos os setores funcionais das demais unidades para recalcular os dados perdidos. Esse procedimento envolve vulnerabilidades severas que o gestor de infraestrutura deve prever ao analisar o downtime e quanto custa cada hora de sistema parado:
- Taxa de erro de leitura irrecuperável (URE): se um único setor defeituoso for encontrado nos discos restantes durante o processo, a reconstrução pode falhar e comprometer o volume inteiro.
- Estresse mecânico prolongado: leituras sequenciais contínuas por dias aumentam a chance de quebra de um segundo disco pertencente ao mesmo lote fabril.
- Degradação severa de I/O: o tempo de resposta da operação interna cai drasticamente, prejudicando o acesso a bancos de dados e documentos corporativos.
Por consequência da densidade das unidades modernas, esse procedimento pode levar dezenas de horas. Caso ocorra uma segunda falha antes do encerramento da sincronização, a tolerância a falhas de hardware deixa de existir, resultando na perda total do volume lógico, o que torna indispensável estruturar um guia completo de disaster recovery corporativo.
Comparativo entre tolerância a falhas e proteção de dados
Muitos gestores confundem a continuidade proporcionada por um conjunto local com uma estratégia completa de preservação digital. Essa configuração com paridade foi concebida para manter a disponibilidade operacional frente à quebra de uma unidade física. No entanto, ela replica instantaneamente qualquer corrupção lógica, exclusão acidental de arquivos ou ataque malicioso por criptografia.
Para manter a integridade dos negócios segundo a regra 3-2-1 de backup, a retenção de dados precisa operar em uma camada desvinculada do hardware produtivo. Enquanto a controladora física responde pela operação em tempo real, a proteção corporativa exige versionamento histórico, controle de retenção e custódia fora da infraestrutura primária.
| Critério de Avaliação | Arranjo Local com Paridade | Backup em Nuvem (xBackup) da SEPTE |
|---|---|---|
| Proteção contra falha de hardware vs. proteção contra ransomware e exclusão acidental | Protege apenas contra pane mecânica de uma unidade; replica exclusões e infecções lógicas. | Reduz o risco de perda por falhas lógicas, ataques maliciosos e exclusões, com backup automático em ambiente separado e retenção configurável. |
| Resiliência durante o rebuild de discos vs. restauração a partir de repositório externo | Vulnerável a parada total caso ocorra taxa de erro de leitura irrecuperável (URE) na reconstrução. | Restauração a partir de repositório separado no S7.DC Data Center do Brasil, sem estresse mecânico no servidor local. |
| Isolamento físico e geográfico dos dados (fora do CPD local) | Inexistente; os dados residem concentrados no mesmo gabinete ou sala técnica da empresa. | Cópia fora do escritório, em data center 100% nacional e sob legislação brasileira. |
| Impacto no desempenho da operação durante recuperação de desastre | Degradação severa de I/O em todo o sistema durante o processo demorado de reconstrução. | Recuperação a partir da cópia externa, sem depender da reconstrução dos discos locais, o que apoia o planejamento de metas de RTO e RPO. |
A arquitetura corporativa exige a combinação adequada entre redundância local e repositórios externos. Os pontos críticos para essa separação funcional envolvem:
- Tolerância a falhas de hardware: mantém o ambiente operacional ativo diante da quebra física de um disco.
- Segregação de riscos: reduz o risco de que sinistros físicos no escritório afetem os repositórios vitais da empresa.
- Recuperação previsível: mantém cópias anteriores dos arquivos, dentro do período de retenção, para restauração em contingências operacionais.
A regra 3-2-1 e a importância do isolamento físico com repositório externo
A proteção de dados em ambientes corporativos exige uma estratégia estruturada que vá além da resiliência local de discos. Embora a tolerância a falhas de hardware mitigue a interrupção operacional imediata provocada pela quebra de um dispositivo, ela não impede incidentes como ataques de ransomware, erros humanos de exclusão ou sinistros no CPD local. Para apoiar a continuidade dos negócios, a governança de TI adota amplamente a regra 3-2-1 de backup como diretriz fundamental de arquitetura.
Essa metodologia estabelece uma distribuição balanceada e independente dos dados em três camadas de proteção:
- 3 cópias dos dados: manter os arquivos primários de produção e ao menos duas versões completas de segurança devidamente atualizadas;
- 2 tipos de mídia distintos: armazenar as cópias em suportes tecnológicos diferentes para evitar perdas causadas por defeitos de um mesmo lote de fabricação;
- 1 cópia fora do local (off-site): manter um repositório isolado geograficamente para suportar falhas críticas no centro de processamento local, como picos elétricos ou danos físicos no prédio.
Sob essa perspectiva, o volume redundante local desempenha apenas a função de sustentação da cópia primária de trabalho, mantendo a operação ativa enquanto os dados continuam no mesmo chassi. Se houver falha de múltiplos discos, corrupção lógica do sistema de arquivos ou sequestro digital, o ambiente precisa de um destino externo devidamente segregado para a recuperação.
A SEPTE atende a essa exigência por meio do Backup em Nuvem (xBackup), enviando réplicas com criptografia em trânsito e em repouso via algoritmo AES-256 para o S7.DC Data Center do Brasil. Esse modelo em nuvem 100% nacional apoia a definição de metas de RTO e RPO, já que a recuperação parte de cópias armazenadas fora da infraestrutura interna do escritório.
Conclusão
A redundância mecânica local reduz o impacto de panes físicas rotineiras, mas manter arquivos apenas no escritório traz riscos graves, como abordado em CPD: os riscos de manter os servidores dentro do escritório. Diante dessa realidade, é fundamental avaliar os tipos de backup para planejar cópias externas.
Para proteger sua operação sem depender apenas de um arranjo RAID 5, a SEPTE oferece o Backup em Nuvem (xBackup). Seus arquivos contam com criptografia AES-256 em trânsito e repouso no S7.DC Data Center do Brasil, infraestrutura 100% nacional com retenção configurável e previsibilidade de custos em Real.
Perguntas Frequentes
Quantos discos podem quebrar no arranjo sem perda imediata de dados?
Essa arquitetura com paridade distribuída tolera a quebra mecânica de apenas uma unidade de armazenamento por vez. Caso um segundo disco sofra pane física antes da conclusão da substituição e sincronização, a tolerância a falhas de hardware é perdida integralmente, resultando na corrupção de todo o volume lógico e exigindo uma rotina de recuperação a partir de repositório externo isolado.
O que acontece se ocorrer um erro de leitura durante a reconstrução?
Se a controladora de armazenamento encontrar um setor ilegível durante a leitura intensiva dos discos funcionais, ocorre o chamado erro de leitura irrecuperável (URE). Esse incidente pode interromper o processo de rebuild do arranjo de discos, comprometendo o recálculo da paridade, e a recuperação passa a depender de cópias de segurança preservadas em outra infraestrutura.
Por que a redundância local não protege contra ataques de ransomware?
A controladora física do servidor gerencia o espelhamento de paridade no nível de blocos de hardware em tempo real, sem interpretar o contexto dos arquivos. Se um código malicioso criptografar diretórios do sistema ou se um operador excluir pastas acidentalmente, essas alterações são gravadas de forma instantânea em todos os membros do arranjo, tornando mandatório o versionamento histórico fora do ambiente local.
Como a regra 3-2-1 de backup se aplica a essa arquitetura de armazenamento?
No modelo da regra 3-2-1 de backup, o arranjo de discos local sustenta unicamente a primeira cópia produtiva de trabalho do ambiente. Para apoiar a continuidade do negócio e cumprir objetivos de RPO e RTO, a organização precisa manter ao menos uma segunda cópia em suporte tecnológico distinto e uma terceira cópia totalmente isolada em repositório fora do escritório corporativo.